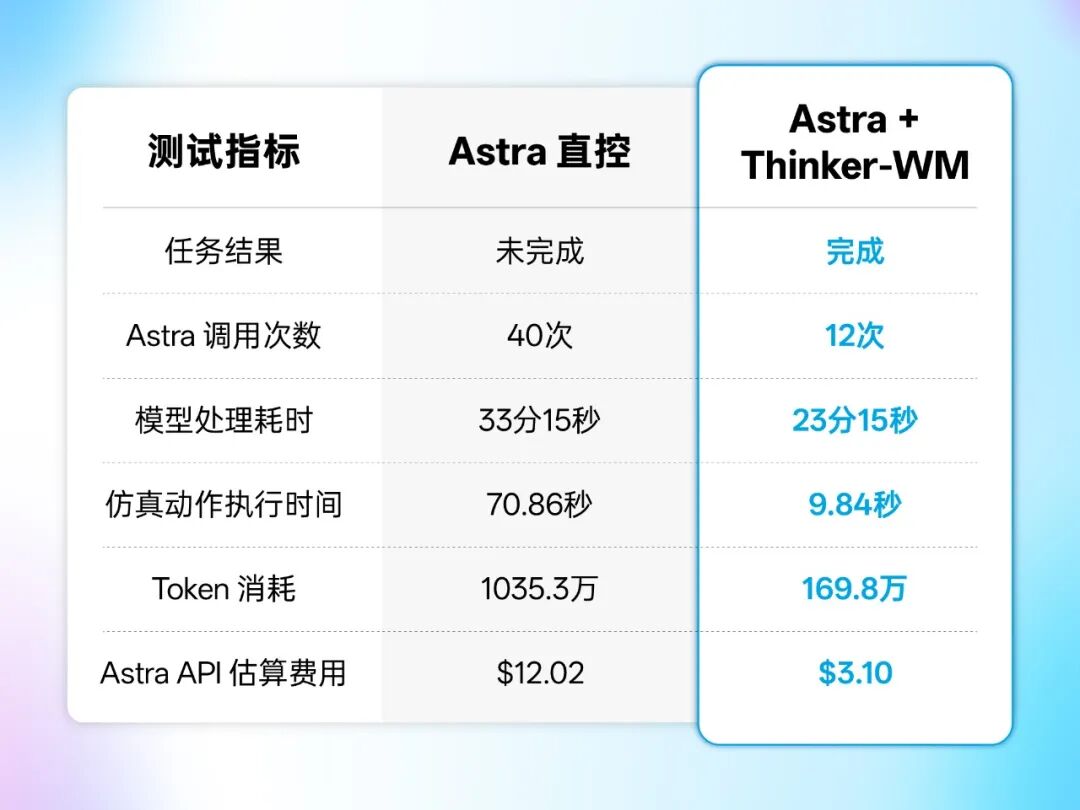
当通用大模型开始直接控制人形机器人,机器人距离真正的自主智能还有多远?
近期,优必选围绕 GPT-6 Astra 开展了一系列真机与仿真测试,探索通用大模型在空间理解、任务规划、运动控制和复杂操作中的能力边界。
从 Astra 直接控制机器人抓取物体,到调用优必选自研 Thinker-VLA 执行精细操作,再到结合 Thinker-WM 世界模型预测未来、辅助动作决策,六组实验呈现出一条清晰的技术演进路径。
实验表明,Astra 已经具备令人瞩目的空间理解与机器人控制能力,能够理解场景、规划任务,甚至直接生成机器人动作。
但与此同时,通用模型“会思考”,并不意味着机器人就能“做得好”。 在真实物理世界中,执行效率、操作精度、任务成功率和推理成本,仍然是机器人走向规模化应用必须解决的核心问题。
而这也恰恰体现了优必选作为人形机器人本体厂商的独特价值:
让通用大模型负责理解与决策,让优必选自研Thinker-VLA模型、世界模型及本体控制系统负责高效、精准地执行,把通用智能真正转化为机器人的实际生产力。
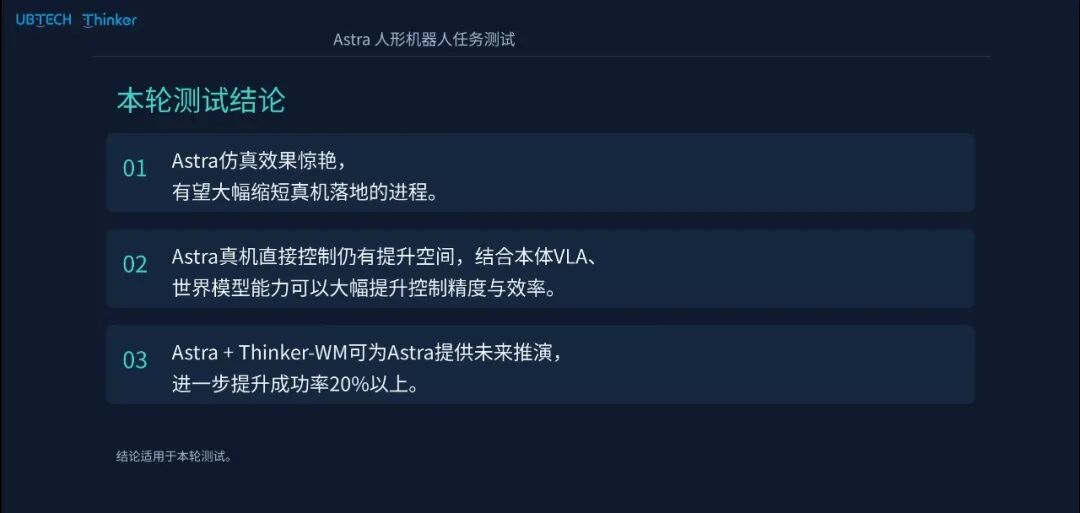
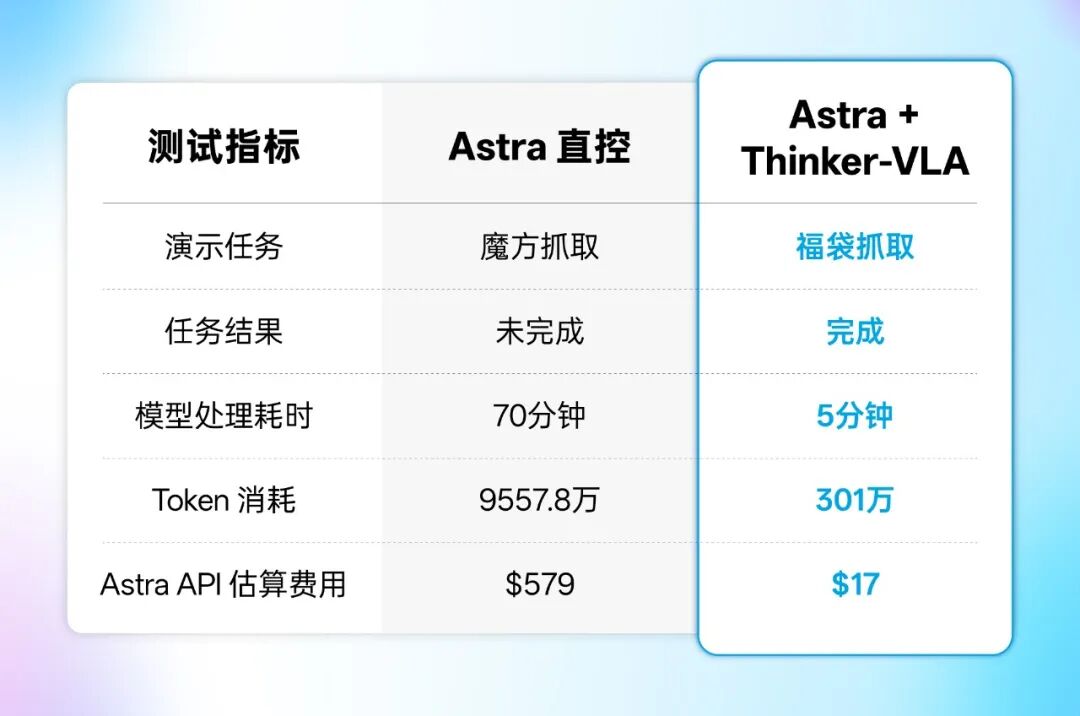
01 真机测试:从Astra直接控制 到具身VLA高效执行 真机实验:Astra 直控魔方、Astra + VLA 抓取福袋、 Astra + 全身 VLA 自主绕障 Astra 直接控制:能理解、能尝试 却难以完成最后一步 在第一组真机实验中,Astra 直接控制优必选 Walker C1 人形机器人,尝试完成桌面魔方抓取任务。 没有专用 VLA 承担抓取动作生成,Astra 需要根据机器人摄像头的实时观察,自主判断目标位置,并规划机械臂的抬升高度、关节姿态、手掌朝向和接近路径。 实验中,机器人能够理解目标、逐步接近魔方,并根据视觉反馈不断调整动作,展现出通用大模型的空间推理与动作规划潜力。 然而,从接近物体到稳定抓取,仍然存在明显的能力鸿沟。 尽管经过多轮尝试,机器人最终未能完成魔方抓取。 与此同时,反复观察、推理和调整也带来了较高的计算成本。 本次实验记录: 模型累计处理耗时:约 70 分钟 Token 消耗:约 9557.8 万 Astra API 估算费用:约 579 美元 最终结果:未完成抓取 这揭示了通用大模型直接控制机器人的现实挑战:它能够理解空间关系、生成动作决策,但面对连续运动和精细操作时,仍可能需要大量推理与反复修正。 能做出合理决策,与能够高效、稳定地完成真实操作,是两个不同层次的能力。 Astra + Thinker-VLA 专业具身模型,让操作更高效 第二组实验中,优必选采用了另一种技术方案:Astra 负责理解任务与调用技能,优必选自研Thinker-VLA模型负责执行精细操作。 在 Walker C1 桌面福袋抓取任务中,Astra 不再需要反复推理机械臂的每一步动作,而是通过调用具身 VLA,将目标操作交由专门训练的机器人策略完成。实验中,机器人成功完成了福袋抓取。 本次实验记录: Astra 调用:仅 2 次 模型累计处理耗时:约 5 分钟 Token 消耗:约 301 万 最终Astra API 估算费用:约 17 美元 最终结果:完成抓取 将两组真机实验放在一起,可以清楚看到两种技术路线的差异: 注:两组实验任务不同,属于不同技术方案的演示记录 并非严格同任务性能对照。 这组测试说明:对于机器人已经具备的专业操作能力,没必要让通用大模型反复推理每一步低层动作。 让 Astra 发挥场景理解、任务规划和工具调用的优势,让优必选自研Thinker-VLA 发挥连续动作生成和精细操作的优势,能够为机器人构建更加高效的执行方式。 Astra + 全身 VLA: 从桌面抓取,走向移动与操作协同 机器人真正进入现实场景,需要的不只是抓取桌面上的物体,还需要自主移动、避开障碍,并将行走与操作连接起来。 在第三组真机实验中,优必选进一步将 Astra 与全身 VLA 相结合。 Astra 根据场景观察进行路径规划与阶段性决策,机器人则调用全身运动能力,穿过障碍物之间的通道、绕开前方障碍,逐步接近目标桌面,并调整最终站姿。 在这一过程中,Astra 主要负责“往哪里走、下一步做什么”,全身 VLA 则承担连续运动执行。 实验记录显示: Astra 模型响应:31 次 Token 消耗:约 641.8 万 Astra API 估算费用:约 7.44 美元 实验阶段历时:约 19 分 30 秒 这组实验初步验证了通用模型与全身 VLA 协同完成移动任务的可行性。 从桌面抓取到自主绕障,优必选正在探索将高层认知、专业操作与全身运动连接为一套统一的机器人执行体系。 02 仿真测试:通用模型很聪明 但复杂任务仍有挑战 仿真实验:篮子搬运、Astra 直接控制叠碗 真实世界中的机器人任务往往并不是一次简单的动作,而是由多个步骤、多个决策和连续运动组成。 为了进一步分析 Astra 的能力边界,优必选在仿真环境中开展了移动操作与桌面精细操作测试。 搬运篮子: 长流程任务考验连续决策与稳定执行 在篮子搬运任务中,机器人需要根据指令移动到目标位置,抓取篮子,并尝试完成后续运输与放置。 Astra 能够观察环境、理解任务要求、规划动作,并通过调用全身 VLA 进行运动执行。 但随着任务步骤增加,机器人在抓取稳定性、动作衔接和连续操作方面逐渐遇到困难。本次实验最终未能完成整个任务。 实验记录显示: Astra 模型响应:192 次 Token 消耗:约 1850.3 万 Astra API 估算费用:约 20.46 美元 这意味着,即使引入了具身执行能力,复杂长流程任务仍然需要解决高层规划与低层执行之间的协同问题。 特别是当操作失败、环境发生变化时,机器人不仅需要判断下一步做什么,还需要具备稳定的动作执行和失败恢复能力。 直接叠碗:空间推理能力强 不代表精细操作能力成熟 另一组仿真实验要求机器人完成桌面叠碗任务。 与篮子搬运不同,这组实验采用 Astra 直接控制机械臂的方式,让模型根据视觉观察判断碗的位置,并持续输出接近、抓取、移动和放置动作。 实验过程中,Astra 能够理解操作目标,并尝试通过多次调整完成任务。但经过 40 次动作决策,机器人仍未成功完成叠碗。 本次实验记录: Astra 调用:40 次 模型累计处理耗时:33 分 15 秒 仿真动作执行时间:70.86 秒 Token 消耗:约 1035.3 万 Astra API 估算费用:约 12.02 美元 任务结果:未完成 这组实验反映出通用模型直接控制机器人的一个关键瓶颈: 对于接触丰富、位置精度要求高的操作任务,模型即使能够正确理解目标,也可能在动作生成、连续控制和误差修正中付出较高代价。 那么,能否让 Astra 不必亲自完成每一步动作,而是利用世界模型提前预测未来,从多个执行方案中选择更优的动作? 优必选进一步开展了第三组仿真验证。 03 Astra + Thinker-WM: 从反复试错,到预测未来、选择动作 仿真实验:Astra + Thinker-WM 预测未来并完成叠碗 世界模型参与决策 让机器人先“预演”,再执行 在这一实验中,优必选将 Astra 与自研具身世界模型 Thinker-WM 相结合,重新挑战此前未能完成的叠碗任务。 Thinker-WM 是优必选自主研发的统一多模态具身世界模型,能够在共享动态表征中联合建模视觉、深度和机器人动作,支持世界预测、动作生成等多种能力。 在本次实验中,Thinker-WM 根据当前场景生成多组候选动作及相应的未来场景预测。 Astra 则利用自身的理解与推理能力,对候选结果进行判断,选择合适的执行方案。 这使机器人的决策方式从传统的直接控制,进一步发展为:观察场景 → 预测未来 → 评估候选 → 选择动作 → 执行反馈。 Astra 不再需要独立承担每一次低层动作生成,而是将连续动作与未来场景推演交给 Thinker-WM,把自身的推理能力更多用于评估和决策。 最终,机器人在本次实验中成功完成了叠碗任务。 数据对比:更少的 Token、更低的推理成本,完成此前未完成的任务。与前述 Astra 直接控制的叠碗实验相比,融合 Thinker-WM 的方案取得了明显不同的结果。 在本次仿真叠碗样例中,Astra + Thinker-WM 实现了: 83.6% 的 Astra Token 消耗减少 74.2% 的 Astra API 估算费用减少 30.1% 的模型累计处理耗时减少 86.1% 的记录动作执行时间减少 任务由本次直接控制未完成,转变为协同执行完成 这里的关键并不仅仅是减少了模型调用次数,而在于改变了机器人完成任务的方式。 Astra 发挥高层认知与决策优势,Thinker-WM 提供物理世界动态预测与可执行动作候选,两者共同构建更加高效的机器人操作闭环。 通过世界模型预测未来,机器人有机会在执行前评估动作可能产生的结果,降低对真实环境反复试错的依赖,为复杂任务中的操作精度、执行效率和稳定性提升提供新的技术路径。 04 Astra 时代 优必选的核心竞争力是什么? Astra 展示了一种令人期待的趋势:通用多模态大模型正在突破传统语言与视觉理解的边界,开始具备直接理解物理空间、规划机器人动作乃至控制真实机器人的能力。 这将为具身智能带来新的发展机遇,也提出了一个重要问题:当通用模型越来越强,具身机器人企业的核心竞争力将体现在哪里? 优必选认为,未来具身智能的关键,不是让通用大模型替代所有机器人专用模型,而是充分发挥不同模型的优势,让通用认知与本体智能深度融合。 通用模型是“大脑” 具身VLA/世界模型是高效执行的“动作专家 Astra 擅长理解复杂指令、分析场景、规划任务,并根据执行反馈调整策略。 但对于高频、连续、精细的机器人动作,让专用 VLA 承担执行,能够更好地利用真实机器人数据、运动控制经验和专业训练所积累的能力。 让 Astra 决定“做什么”,让 VLA 解决“怎么做”,是实现开放任务能力与高效执行的重要路径。 世界模型赋予机器人预测未来的能力 相比直接生成动作,世界模型进一步为机器人提供了预测动作后果的能力。 优必选 Thinker-WM 将视觉、空间几何和机器人动作进行统一建模,能够预测未来场景变化,并生成相应动作。 结合 Astra 的高层理解与推理能力,机器人有望从被动执行指令、依靠反复试错,向基于未来预测的主动决策演进。 通用模型负责理解与判断,世界模型负责预测与生成,两者协同,为更复杂、更精准的机器人操作提供新可能。 本体、模型与真实数据闭环 是机器人智能落地的关键 机器人真正进入工厂、家庭和其他现实场景,不仅要理解任务,还必须具备可靠的全身运动、精细操作、实时反馈和持续改进能力。 作为兼具人形机器人本体、运动控制、真实场景数据和自研具身模型能力的企业,优必选能够围绕实际机器人任务,将高层规划、VLA、世界模型与全身运动能力深度结合,并通过真实执行反馈持续优化。 这种贯通“认知—预测—决策—执行—反馈”的完整能力,是推动机器人从实验演示走向实际应用的重要基础。 05 结语:让通用智能 真正转化为机器人的行动力 从 Astra 直接控制机器人,到调用Thinker-VLA 完成精细操作,再到结合 Thinker-WM 预测未来,这六组实验展示了通用大模型与具身智能融合的不同技术路径,也揭示了当前机器人走向实际应用仍需突破的挑战。 通用大模型的发展,正在为机器人提供更强大的认知与规划能力;而机器人本体、专业具身模型与真实世界数据,则决定了这些智能能否被高效、精准、可靠地执行。 未来的机器人,不仅要拥有能够理解世界的“大脑”,更要拥有能够精准行动的“身体”,以及能够预测未来、持续改进的智能系统。 优必选将持续探索通用大模型与自研Thinker-VLA、Thinker-WM、全身控制技术的深度融合,让机器人不仅能够理解任务,更能够真正完成任务。 让 AI 从“会思考”走向“会行动”,让具身智能从技术演示走向真实生产力。