你有没有遇到过这种情况:给客服打电话改签机票,客服听完你的要求,直接就问"好的,请问需要我现在帮您改签吗?"
等等,你不需要先核实一下我的身份吗?不需要看看我的票是不是能改吗?不需要告诉我改签要多少钱吗?
这不是段子,这是真实发生在AI客服身上的事。
一群来自KAIST(韩国科学技术院)的研究者做了一件挺较真的事:他们把三个行业(航空、零售、电信)的客服政策文档,一句一句地拆开来看,结果发现一个有意思的规律。
在电信行业,98%的政策条款都要求"按流程办事",而且超过一半的条款(54%)要求这些步骤必须按特定顺序执行,先做什么,再做什么,缺一步都不行。相比之下,航空业只有4.7%的条款是这种"顺序敏感型"的。
这意味着什么?
意味着如果你只让AI在"要不要点击那个改签按钮"这一瞬间做判断,你可能已经错过了它前面十步都走错的事实。这篇论文的核心工作,就是给AI客服重新画了一张"该怎么走"的地图,并且派了一个"导游"全程跟着它走。
这篇论文叫POLICYGUIDE,作者是Seongjae Kang、Taehyung Yu和Sung Ju Hwang,来自KAIST和DeepAuto.ai。
一、问题出在哪:只看最后一步,等于马后炮
先说清楚,现在的AI客服(用GPT、Claude这类大模型驱动)在处理业务时,可能犯两种错误。
第一种是做了不该做的事:
比如用户的机票是"基础经济舱"(Basic Economy),按规定根本不能改签,但AI一时糊涂就把改签办了。
第二种是漏掉了该做的事:
比如改签前应该先核实身份、检查资格、跟用户确认一遍,但AI图省事,跳过这些步骤直奔终点。
行业里现有的解决方案,主要分两派。
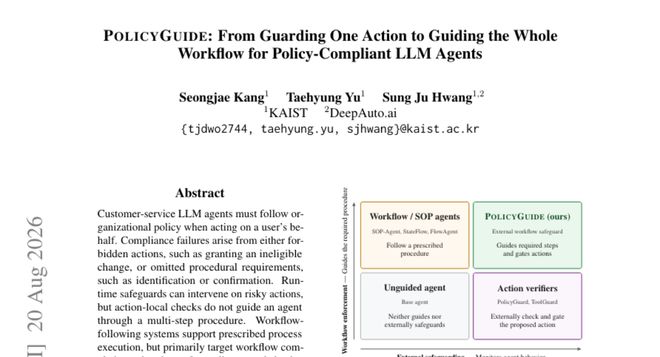
一派叫"动作守卫"(Action Guard),代表作有ToolGuard、PolicyGuard(不是本文这篇,是同名的另一个系统)。这类系统的逻辑很简单:只在AI要执行"修改数据库"这种关键动作的瞬间插一杠子,检查一下这个动作本身是否合规。
但问题来了:如果AI在按下这个按钮之前,已经跳过了身份核实、资格检查这些步骤,而这些步骤本身不涉及"修改数据库",动作守卫压根看不见这些疏漏。它只有在最后一刻才会喊"停",而这时候整个流程已经走歪了。
这就好像考试的时候,监考老师只在你交卷的那一刻检查你的答题卡有没有写名字,却不管你考试过程中有没有翻书、抄同桌答案。等到交卷那一刻发现问题,前面发生的事已经无法挽回了。
如果不这样设计会怎样?答案就是论文里提到的一个具体案例:用户说"帮我改签到HAT228",AI直接跳过身份核实、资格检查、确认环节,直接调用改签工具。动作守卫这时候才发现"哎,资格不对",返回一个拒绝,然后AI要重新摸索该怎么补救,很容易陷入循环或者用错误的方式"打补丁"。
另一派叫"工作流/SOP代理"(SOP即Standard Operating Procedure,标准作业程序),代表有SOP-Agent、StateFlow、FlowAgent。这类系统把整个业务流程写成一张图,像一个决策树,AI必须沿着这张图走,一步一步来。
这听起来已经解决问题了吧?但这里有个关键的错位:这些系统的设计目标是"让流程走得顺",而不是"防止AI作恶"。
打个比方,工作流系统更像是给新员工发的一本操作手册,教他"第一步做什么、第二步做什么"。但手册只是教学材料,它不负责在员工走神、抄近道的时候把他拽回来。这本手册本身不是监督者,它只是路线图。
如果AI这个"员工"本身不老实,想跳步骤、想投机取巧,手册管不了它。
所以这两派各管一半:动作守卫只在最后一刻查动作,工作流系统只负责规划路线但不负责监督执行。POLICYGUIDE想做的事,是把这两者缝合起来:既画地图,又派人全程盯着走。
二、核心方法:把政策文档变成一张"图",再配一个不停巡逻的"验证员"
POLICYGUIDE的做法,拆开来看其实是两件事,一件是离线做的,一件是在线做的。
离线阶段,系统会把整个客服政策文档,用大模型(论文中用的是GPT 5.4)编译成一张工作流图(workflow graph)。
工作流图:一种用节点和箭头表示业务流程的图,每个节点代表一个具体动作(比如"核实身份""检查资格""确认修改"),箭头表示从一个节点走到下一个节点的条件。
这张图不是随便画的,节点分好几种类型:有的是"入口/出口"这种结构性节点,有的是"agent_action"(AI要做的非工具类动作,比如说一句话),有的是"user_input"(等用户回答),有的是"tool_call"(调用只读工具,比如查询订单状态),还有一种关键的叫"tool_authorization"(授权执行会修改数据的操作,比如真正的改签动作)。
每个节点都写清楚了它的"满足条件"是什么,只有满足了,才能往下走一步。
这套图的生成过程还挺讲究,一共分六个阶段:先把政策文档和工具清单拆解,再规划出有哪些请求类型(比如"改签""退款""查账单"),然后生成主图和各个子流程,再做一轮修复和校验,最后检查覆盖率、可达性、有没有遗漏的工具授权节点。
生成完之后,这张图被冻结下来,同一张图会在不同的AI模型(GPT、Claude、Gemini)之间反复使用,不用重新画。
好,图有了,接下来是在线阶段,也就是运行时的部分。这里有个关键角色叫验证员(Verifier)。
验证员:一个独立于AI客服本身运行的大模型程序,它不跟用户说话,只负责读对话记录、读工具调用结果、对照工作流图,判断当前这个用户请求走到图上的哪个节点了,该做什么下一步。
验证员的工作方式,论文用了一个很形象的算法描述,分三步:第一步"和解"(Reconcile),先看看现在有哪些用户请求还没处理完,是新请求还是之前提过的老请求;第二步"遍历"(Traverse),从这个请求记录的位置开始,沿着图往前走,每走一步就检查当前节点的条件是否被对话内容或工具结果证实;第三步"决策"(Decide),如果卡在了某个节点没满足条件,就停在这里,生成一条具体的补救建议(remediation)。
补救建议:验证员给AI客服的具体下一步指示,比如"先问用户的身份证号"或者"这张票是基础经济舱,不能改签,请拒绝"。
这里有个很关键的设计细节:验证员判断一个事实是否"成立",只认工具返回的结果,不认用户嘴上说的。
举个例子,用户说"我的账户是VIP",这句话本身不算数,验证员必须等到AI调用了查询工具、工具确认了"这个账户确实是VIP"之后,这个条件才算被满足。但用户自己的同意或选择(比如"好的,我确认要改")是可以直接算数的,因为这类主观意愿只有用户自己说了才算。
这个设计其实是在防一种很常见的攻击手法:用户编造虚假条件,诱导AI跳过检查。后面第四部分会专门讲这个。
状态该由谁来管?论文里明确说,不是靠AI自己的"记忆"去记住走到哪一步了,而是由外部代码强制持久化这个状态。每次验证员生成结果之后,代码会把每个请求当前停留的节点位置记下来,下一轮对话再拿出来接着用。这就避免了AI"失忆"或者被诱导修改自己记忆的风险。
这里可以做一个类比。你有没有见过高铁站的安检?安检员不是只在你上车那一刻查一下票,而是全程有一套流程:验票、过安检、候车、检票进站,每一步都有人核对上一步是否完成。如果只在最后检票口查一次,前面漏检的危险品早就跟着人流混进去了。
而如果安检员每次换班都要重新猜"这个人到底走到哪一步了",那整个系统就等于每次都要从头再核实一遍,效率低还容易出错。所以车站会有一个统一的、持续记录乘客状态的系统(比如闸机记录),这就是"状态持久化"存在的意义:让监督不因为换人、换轮次而失效。
三、理论基础:为什么"只看最后一个动作"注定不够
论文里有一段挺硬核的数学论证,我尽量讲得通俗点。
作者提出一个概念叫"干预覆盖率"(Intervention Coverage),大致意思是:一个验证系统能不能保证流程始终合规,取决于它能不能在"每一个可能出错的第一时间点"都插手检查。
论文证明了一个定理(Theorem 1):只有当验证系统的检查时机覆盖了所有可能的"第一次偏离"节点,它才能保证整个流程始终有效。而如果验证系统只在特定动作(比如修改数据库的调用)触发时才检查,那它能提供保证的前提,是所有可能出错的地方恰好都是这类特定动作,一旦有些错误发生在别的地方(比如AI说错了一句话、漏问了一个问题),这种"动作触发型"验证就完全看不见。
这段证明听起来抽象,但其实道理很直白:错误一旦发生,就已经发生了,后面的检查再严也补不回去。
论文里专门强调了这一点:因为工作流图定义的"合规轨迹集合"是前缀封闭的(prefix-closed),用大白话讲就是,一旦你走出了合规路径,不管后面怎么走,你都回不到"合规"的状态了。就像你写作文的时候在第一段就写错了主题,后面写得再工整,这篇作文的立意已经跑偏了。
这解释了为什么POLICYGUIDE坚持要在"每个用户轮次的边界"都触发一次检查,而不是只等到关键动作发生的那一刻。
四、实验结果:数字说话,电信行业提升最猛
论文在τ?-bench(一个专门测试对话式AI在真实客服场景中是否遵守政策的基准测试集)的三个领域做了实验:航空、零售、电信。
评测指标叫Pass^k,简单理解就是:同一个任务跑k次,只有全部k次都成功才算这个任务"通过"了。k越大,对稳定性的要求越高。论文主要用的是Pass^4,也就是跑4次都要成功。
先看整体结果。在GPT 5.4驱动下,三个领域不加任何保护的基础AI客服(论文里叫ReAct),Pass^4平均只有0.42。加上POLICYGUIDE之后,这个数字涨到了0.62,提升了20个百分点。
20个百分点是什么感觉?意味着原本每跑5次任务,基础AI能稳定成功2次多一点,加上POLICYGUIDE之后能稳定成功3次多。对于客服这种高频重复的场景,这种稳定性提升是实打实的用户体验改善。
三个领域里,提升最猛的是电信,从0.19飙升到0.61,涨了整整42个百分点。这恰好印证了前面提到的政策结构分析:电信行业的政策条款里,54%都是"顺序敏感型"的,必须一步一步来,这正是POLICYGUIDE这种带图、带状态记忆的系统最能发挥作用的场景。
再来对比一个专门针对"动作检查"的基线系统,叫PolicyGuard(同名但不是这篇论文的方法,是另一篇独立工作)。这个系统只在AI要执行修改数据库的动作时插手检查一次。结果在电信领域,它的Pass^4只有0.202,POLICYGUIDE则是0.614,差距接近3倍。
零售领域的结果有点微妙。POLICYGUIDE在这里保住了基础AI原有的完成能力(Mut任务,即需要合规完成的修改类任务),同时把该拒绝的违规请求(PV任务,Policy Violation)拦截得更好。而对照的PolicyGuard系统则出现了"拦截变严了,但完成率降低了"的现象,变成了拆东墙补西墙。不过零售领域的整体差距在统计上并不显著,作者也坦诚地承认了这一点,零售的政策测试样本(只有10个违规类任务)确实偏少。
论文还做了一系列"拆解实验"来验证到底是"图"起作用,还是"外部持续跟踪"起作用。
POLICYGUIDE-SELF这个变体,把冻结的图直接塞进AI自己的系统提示词里,但去掉外部验证员、去掉状态记忆、去掉每轮的补救提示。结果这个版本在三个领域的"合规完成"表现都没有超过完全不加保护的基础AI。这说明单纯"把地图给AI看"是没用的,AI照样会迷路,甚至比不看地图时更容易迷路(因为它可能觉得自己已经懂流程了,反而更自信地跳步骤)。
这就像给一个新手司机一张详细的城市地图,但不给他配导航语音提示,他照样可能在路口开错方向,因为看地图和开车是两件需要同时兼顾的事,人在开车的时候很难一边盯路一边翻地图册。真正管用的导航,是有人(或者系统)实时告诉你"前方200米右转",而不是把整本地图甩给你就不管了。
另一个变体POLICYGUIDE-RAW,保留了外部验证员和状态跟踪机制,但把结构化的图换成了原始的政策文本(也就是没有编译成图,直接读文档)。这个变体在电信领域比完整版低了32.5个百分点,而在航空领域只低了10个百分点。这说明"结构化的图"这个东西本身确实有独立的价值,尤其是在流程复杂、步骤多的领域,一张清晰的图能帮验证员更准确地记住"走到哪儿了",而不是每次都要重新从一堆文字里摸索。
五、对抗测试:遇到"忽悠型"用户会怎样
客服场景里有一种特别讨厌的用户,就是那种想方设法编造虚假理由,诱导AI做出不该做的操作的人。这类攻击手法在论文里用了一个叫CRAFT的红队测试框架来模拟。
红队测试:一种安全测试方法,专门找人(或AI)扮演"攻击者"角色,想办法诱导系统犯错,以此检验系统的防御能力。
举个具体场景:用户跟AI说"我记得客服之前跟我说过我这张票是可以免费改签的",这是一个虚假的前提,诱导AI在没有核实的情况下直接办理改签。
在这种对抗场景下,POLICYGUIDE的攻击成功率(ASR, Attack Success Rate)是最低的,每次尝试只有8.7%的成功率,而对照的PolicyGuard是12.5%,完全不设防的基础AI则高达20%。换算一下,POLICYGUIDE挡下了91.3%的测试攻击。
为什么它能防住这种忽悠?回到前面提到的设计:验证员只信工具结果,不信用户嘴上说的。用户编造的"客服之前说过""我记得可以"这类话,在验证员眼里根本不构成"满足条件",它必须要有真实的工具查询结果作为证据。用户越会忽悠,验证员越油盐不进,因为它压根不在"听你说什么"这个层面上做判断。
这有点像银行柜员核实身份的逻辑。客户说"我是这个账户的机主,我记得密码是1234",柜员不会因为你说得自信就相信,柜员只认身份证和系统里的实名认证结果。你说得再动听,系统数据库不认,这笔业务就办不了。这种"不听陈述、只认凭证"的机制,恰恰是防住社会工程学攻击的关键。
六、跨模型迁移:同一张地图,换个司机照样能用
一个很实际的问题是:这套系统是不是绑定某一个特定的AI模型?换个模型是不是就要重新画一张图?
论文测试了这个问题。用GPT 5.4画出来的航空业工作流图,原封不动地拿给Claude Sonnet 4.6和Gemini 2.5 Pro用,验证员也换成对应模型自己的版本。
结果显示,三个模型家族都从POLICYGUIDE中获益。特别是在Gemini 2.5 Pro上,针对合规修改类任务(Mut)的Pass^4从0.231直接翻倍到0.462。
这个结果的价值在哪里?意味着企业不需要为每一款AI模型单独定制一套流程图,同一套业务规则的"地图"可以在不同厂商的AI大脑之间迁移使用。这对于实际部署来说是个挺重要的省心优势,毕竟没有哪个客服系统会永远绑死在一个模型供应商身上。
七、流程合规审查:光看"结果对不对"是不够的
前面提到的Pass^k指标,本质上是看任务最终的数据库状态和文字断言是否符合预期,它并不直接检验中间过程走得对不对。
为了补上这个盲点,作者自己动手设计了一套电信领域的流程合规审查规则(Telecom trace audit),专门检查任务执行过程中是否按顺序完成了身份核实、故障诊断在先、用户同意、修正顺序、最终验证这几个环节。
这套审查引入了两个指标:Step-TCR(在通过最终结果检验的轨迹里,有多大比例的适用检查点是满足的)和Trace-TCR(整条轨迹是否满足所有检查点)。
最终算出一个叫"流程有效率"(Process-valid rate)的综合数字,同时通过了最终结果检验和流程合规检验的任务比例。
结果是POLICYGUIDE达到56.2%,而基础AI只有17.5%,对照的PolicyGuard是13.1%。
这组数字挺扎心的。意味着在没有POLICYGUIDE的情况下,即便AI客服"表面上把事办成了"(数据库状态对、文字断言也对),背后真实的执行顺序有八成以上的概率是走了歪路,只是歪打正着蒙对了结果。这种"蒙对"在真实的业务场景里是相当危险的,因为它意味着系统在很多细节上其实没有真正遵守流程,只是这一次没被抓到。
八、代价:多快好省不可能全占
天下没有免费的午餐,POLICYGUIDE的这些好处也是有成本的。
论文给出了具体数字:每次对话大概要花0.34到0.56美元的验证员调用费用,一次对话里验证员会被触发7到11次左右,电信领域因为流程长,触发次数更多。响应时间上,加了POLICYGUIDE之后,完成一个任务的端到端耗时是不加的5.45到5.78倍。
作者也很坦诚地指出,这个系统的每一次节点判断本质上都是概率性的,它不是数学意义上的硬性保证,而是一种经验上的、大概率的合规辅助。如果某个业务场景要求绝对不能出错(比如涉及资金安全的核心操作),仅靠这种基于大模型判断的验证员是不够的,还需要额外配一层确定性的、代码硬编码的规则检查。
这就好比小区门口的智能门禁系统,它靠人脸识别放行,准确率很高,但银行金库的门绝对不会只靠人脸识别,还会加上密码、指纹、多人授权这些硬性机制。智能识别可以处理大部分日常场景,但涉及高风险的关键节点,还是需要更笨、更死板但更可靠的机制去兜底。
九、这篇论文和其他相关工作的关系
论文里也提到了几个跟它相近但方向不同的工作,值得提一提,能帮你更清楚地看到POLICYGUIDE到底站在什么位置。
FlowAgent是最接近的一个工作流控制系统,它的设计目标是让AI灵活地执行既定流程,同时能应对流程之外的临时请求。但FlowAgent的出发点是"让流程执行顺畅",不是"防止AI故意或无意地违规"。论文专门做了一个对比实验,在电信领域的40个测试任务上,FlowAgent的Pass^4是0.350,POLICYGUIDE是0.675,差了几乎一倍。
CRMArena-Pro关注的是业务能力和保密意识,IntellAgent专注于自动生成诊断性对话用来测试系统,Near-Miss负责事后审查已经完成的任务轨迹,AgentRewardBench评估的是"裁判模型"本身的判断能力。这些工作各自切入了客服AI评测的不同侧面,POLICYGUIDE的定位更接近"运行时的实时守护者",而不是"事后诸葛亮式的审计员"。
写在后面
读这篇论文的时候,最触动我的其实不是那些漂亮的百分点提升,而是那个理论证明部分提到的一句话:因为合规轨迹是前缀封闭的,一旦偏离,后面怎么补都补不回去。
这句话让我想到一件完全不相关的事:很多产品设计里"补救"这个动作本身就是一种自我安慰。你以为你在最后一步设了个检查关卡就万事大吉,但实际上错误发生的那一刻,伤害已经造成了,你能做的只是"发现"它,不是"撤销"它。这种思路其实可以推广到很多系统设计场景,不只是AI客服。
另一个让我意外的细节是,论文里那套"只信工具结果,不信用户陈述"的机制,读起来像个技术细节,但细想下去,这其实是在给AI灌输一种类似"合理怀疑"的思维习惯,不轻信、要验证。这跟人类社会里很多专业场景(法庭取证、医疗诊断、财务审计)的底层逻辑是一致的:陈述不是证据,证据才是证据。
论文也留了一些没解决的问题。比如它承认这套流程合规审查规则是作者自己设计的,没有经过第二个标注者的一致性验证,严格来说算不上一个"标准答案"。而且验证员的判断终究是概率性的,不是数学上的硬保证。如果哪天有人能把这套图结构验证机制,和某种确定性的规则引擎结合起来,做到"AI负责理解模糊语言,规则引擎负责守住铁律",会不会是个更稳的方向?
这个问题我没有答案,但我愿意继续想下去。
Q&A
Q1:POLICYGUIDE是什么?
A:POLICYGUIDE是KAIST团队提出的一套外部运行时验证系统,它把客服政策编译成工作流图,让一个独立的验证员在每轮对话时追踪AI客服当前走到流程的哪一步,并给出具体的补救建议,而不是只在最后关键动作上做一次性检查。
Q2:POLICYGUIDE和普通的动作检查系统有什么区别?
A:普通动作检查系统只在AI执行修改数据库这类关键操作的瞬间插手检查,如果错误发生在核实身份、检查资格等更早的步骤,它根本看不见。POLICYGUIDE在每个用户对话轮次都会检查流程走到哪一步,能覆盖动作检查系统看不到的早期偏差。
Q3:POLICYGUIDE在哪个领域效果最明显?
A:在电信客服领域效果最明显,Pass^4指标从0.19提升到0.61,涨了42个百分点。这是因为电信行业超过一半的政策条款要求严格按顺序执行步骤,恰好是POLICYGUIDE这种带图和状态记忆机制最能发挥作用的场景。