这不是收缩,是换了一种方式继续加速
翻译成人话就是:路堵了就翻墙,反正算力必须建。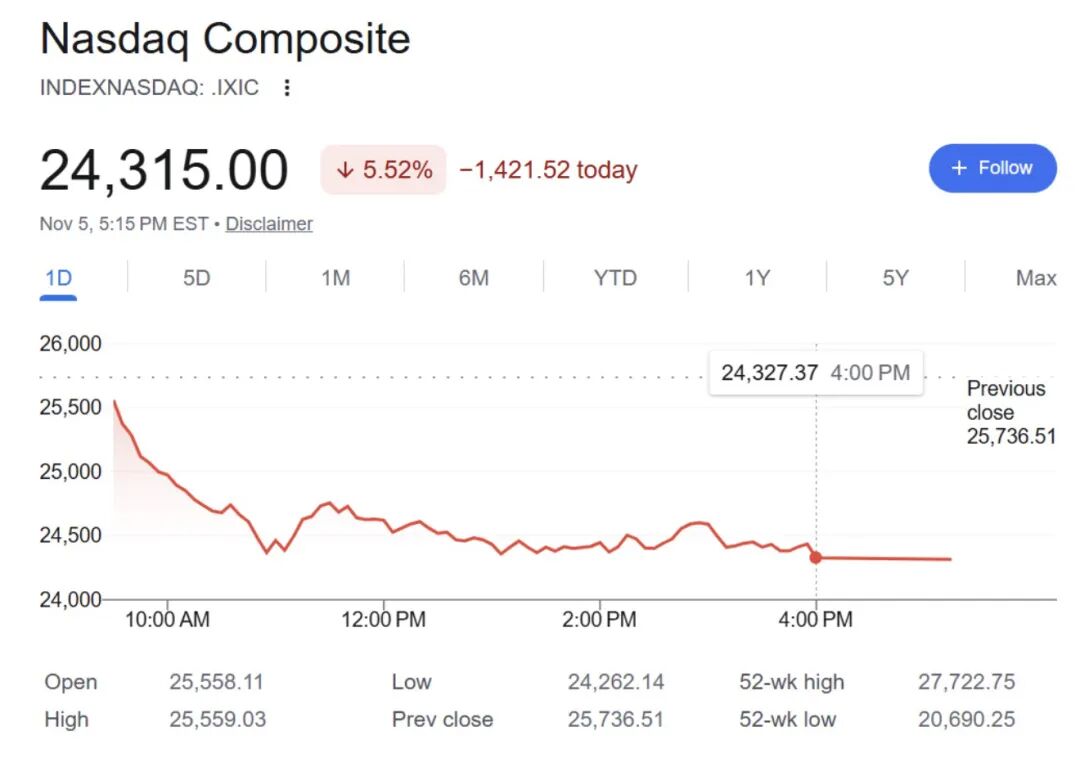
02|为什么说这不是退缩,是更聪明的进攻
有人可能会说:英伟达都开始改旧楼了,是不是行业见顶了?恰恰相反。
一个真正见顶的行业,做法是收缩、砍项目、延迟投资。微软确实在砍一些高风险项目,但英伟达在干嘛?它在主动找新路径,把建设规模做到1GW。
这两件事看起来矛盾,其实是同一件事的两面:需求实在太旺,旺到必须换一种方式来满足。
分布式小节点方案的聪明之处在于:
第一,快。旧楼改造6到12个月就能上线,新建园区要三到四年。在AI算力供不应求的当下,速度就是钱。早一年上线,就早一年吃到算力溢价。
第二,灵活。小节点用电负荷小,电力申请门槛低,不需要等GW级并网。哪个地方有电、有政策,就往哪里放。
第三,就近。AI推理需求对延迟极度敏感,数据中心离用户越近越好。分布式小节点可以直接布到需求侧附近,不用全部挤在几个大园区里。
这不是退路,是一条更高效的进攻路线。
03|中国算力产业,我们早已走在这条路上
英伟达在北美折腾"旧楼改造",听起来像个创新解法。但在中国,这种"找现有条件、快速建算力"的模式,已经跑了好几年了。
中国的情况其实更特殊:电力资源在西部(内蒙、贵州、宁夏),AI需求在东部(北上广深)。我们不可能像美国那样在需求中心附近建GW级园区,因为电不够。
所以中国算力行业很早就在做一件事:找有电、有地、有政策的地方,把智算中心建起来,再通过光纤把算力送过去。
芯魔方做的,就是这件事的全栈版本。
第一,智算中心共建。在绿电资源充足的区域,跟地方政府和能源方合作建AIDC,绿电直供成本低到0.35元每度。这不就是英伟达"找现成建筑绕开审批"的逻辑吗——不是硬闯电网,而是找有电有地的地方一起建。
第二,万卡级集群极速交付。从签约到万卡集群上线,传统数据中心建设要一两年,芯魔方通过预制化模块、标准化部署、供应链协同,把周期压到月级。这就是"快"——跟英伟达改旧楼抢时间是同一个思路。
第三,算力资产化运营。集群上线不是终点,是运营的起点。芯魔方做算力租赁、调度优化、全生命周期管理,把集群利用率拉高25%以上。建得快不够,还要用得好——每一张卡都在创造价值,这才是真正的竞争力。
第四,算力后市场资产循环。GPU三到五年就换代,旧卡怎么办?芯魔方做的是算力资产的二手流转、降级使用、残值管理。跟英伟达"不浪费现有建筑"是同一个思路——已经投下去的资产,要继续用、反复用。

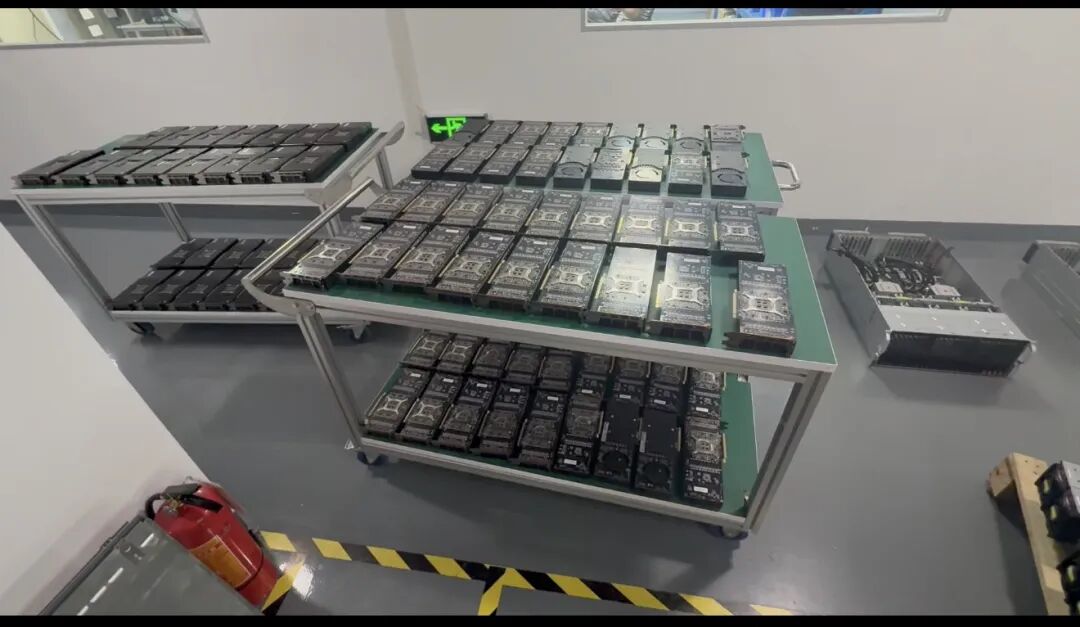
(图片为芯魔方实拍工作图盗图必究)
04|一个判断:需求刚性压倒一切约束
把两条新闻放在一起看,结论很清楚。上周SemiAnalysis预测2027年全球新增数据中心IT容量翻倍到51.2GW。这周英伟达就开始研究怎么把旧楼变成数据中心。
一边是审批趋严、电力不够、成本上涨,另一边是就算绕路也要把算力建起来。这说明什么?说明AI算力的需求,已经刚性到了"约束再多也挡不住"的程度。增量建设时代的逻辑是:谁拿到地、拿到电、拿到卡,谁就赢。但约束越来越多之后,真正的竞争壁垒变成了:谁能在有限条件下,更快、更省、更高效地把算力建起来并用好。
英伟达改旧楼,是在北美市场做这件事。芯魔方做智算中心共建、60天交付、资产运营、后市场循环,是在中国市场做同一件事。芯片决定算力的上限,运营能力决定算力的下限。下一个十年,算力行业的门票,不是"谁能建最大的机房",而是"谁能在约束中把每一张卡都用出价值"。需求压不住,建设不停步。这就是当下算力行业最确定的事。
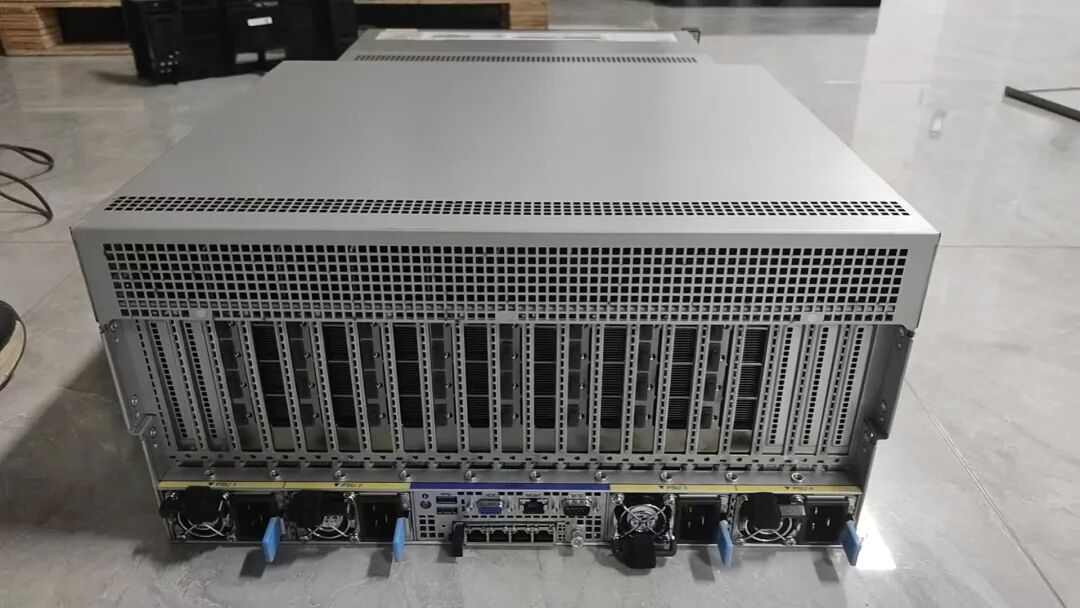
(图片为芯魔方实拍工作图盗图必究)